Blog Article
HTTP通信の仕組みについて
HTTPとは
HTTPは、インターネット上でデータをやり取りするルールを決めた仕組み (プロトコル) です。簡単に言えば、ウェブページや画像などの情報をクライアント (ブラウザ) とサーバー間で送受信するための手順です。
HTTPの基本ポイント
- リクエストとレスポンスの仕組み
- クライアント (例: ブラウザ)がリクエストを送信します。
例: 「このページを見たい!」 - サーバーがそのリクエストに応じてレスポンスを返します。
例: 「ページのデータをどうぞ!」
イメージ:
あなた (クライアント) がレストランで注文 (リクエスト)
店員 (サーバー) が料理を提供 (レスポンス)
- クライアント (例: ブラウザ)がリクエストを送信します。
- ステートレス (状態を覚えない)
HTTPでは、1回のリクエストとレスポンスが完結します。サーバーは「前回何を頼んだか」を覚えていません。
例: ブラウザがページを開くたびに、新しいリクエストが送信されます。注意: ユーザーの状態 (ログインなど) を覚えさせるためには、クッキーやセッションなどの仕組みを追加で使います。
- テキスト形式でやり取り
HTTPの通信はテキストで書かれており、人間が読める形になっています。
ブラウザが
index.htmlというページを要求する命令の例 ↓
例:GET /index.html HTTP/1.1
- 暗号化されない (非安全)
HTTPは通信を暗号化しません。送ったデータがそのまま外部に見えるリスクがあります。
HTTPS (HTTP Secure) を使えば暗号化され、安全に通信できます。
- ポート番号80
通常、HTTP通信はポート80を使用します。
URLにポート番号を書かない場合でも自動的に80が使われます。
- 拡張性が高い
HTTPには、ヘッダーという追加情報を送る仕組みがあります。
例: ユーザーのブラウザ情報や言語設定を伝えるます。また、新しい機能を後から追加しやすいプロトコルです。
HTTPSとは
HTTPSは、インターネット上のデータ通信を暗号化して安全にする仕組みです。簡単に言えば、通常のHTTP通信に「鍵をかける」ことで、第三者にデータを盗み見られないようにしています。
HTTPSの基本ポイント
- 通信の暗号化
通信データを暗号化して、他の人が内容を読めないようにします。たとえば、クレジットカード情報やパスワードを送るときも、暗号化されていれば安心です。
イメージ:
手紙の内容を読まれないように、特別な鍵で封をするようなもの。
- 公開鍵と秘密鍵の仕組み
サーバーは「公開鍵」と「秘密鍵」のペアを持っています。
・公開鍵: 誰でも使える鍵 (暗号化に使う)
・秘密鍵: サーバーだけが持つ鍵 (復号に使う)
公開鍵を使ってデータを暗号化すると、秘密鍵を持つサーバーだけがその内容を解読できます。
- SSL/TLSハンドシェイク
HTTPSのSSL / TLSハンドジェイクの仕組みについて
HTTPS通信を始める前に、クライアント (ブラウザ) とサーバーの間で「通信を安全にする準備」をします。
このやり取りを「ハンドシェイク」と呼びます。
流れ:
- クライアントがサーバーに「証明書」をくださいとリクエスト。
- サーバーが公開鍵と証明書を渡します。
- クライアントがその証明書を確認し、安全な暗号化方法を決定。
- その後、暗号化された通信が始まります。
- SSL証明書 (証明書の役割)
サーバーが信頼できることを証明するものです。証明書には、サーバーの公開鍵や運営者情報が含まれており、「認証局 (CA) 」という機関が発行します。
例:
証明書があれば、偽サイトではなく本物のサイトと通信していると確認できます。
- セキュリティ向上の理由
- データの盗聴防止: 第三者が通信内容を盗み見ても解読できません。
- データ改ざん防止: データが途中で改ざんされていないことを確認できます。
- 正当性の保証: サイトが本物であることを証明します。
HTTPSが重要な理由
- パスワードやクレジットカード情報を送信する際に、情報漏洩を防ぐため。
- 信頼性の証明 (ブラウザに「鍵マーク」が表示され、安心感を与える)
- 検索エンジンでも、HTTPSサイトが優遇されることが多い。
HTTP メッセージとは
HTTP メッセージとは、ブラウザなどのクライアントと Web サーバーが、HTTP を使ってデータをやり取りするときに送受信するメッセージのことです。
例えば、ブラウザで https://example.com/index.html にアクセスすると、ブラウザはサーバーに「index.html を取得したい」という HTTP リクエストを送ります。それに対してサーバーは、「要求されたデータを返します」という HTTP レスポンスを返します。
HTTP メッセージには、大きく分けて HTTP リクエスト と HTTP レスポンス の 2 種類があります。まずは、それぞれがどのような構造になっているのかを全体で確認します。
HTTP メッセージの全体像
HTTP リクエストと HTTP レスポンスは、それぞれ次のような構造になっています。
HTTP リクエスト
GET /index.html HTTP/1.1
Host: www.example.com
User-Agent: Mozilla/5.0

name=John&age=30
HTTP レスポンス
HTTP/1.1 200 OK
Content-Type: text/html
Content-Length: 123

<html>
  <body>Hello, World!</body>
</html>
この 2 つを比べると、どちらも「情報をいくつかの部分に分けて送っている」ことが分かります。
リクエストでは、最初に「何をしてほしいのか」を示し、その後に追加情報を付けます。必要であれば最後に送信するデータを入れます。
レスポンスでは、最初に「リクエストがどうなったのか」を示し、その後に追加情報を付けます。最後に、要求された HTML や JSON などのデータを入れます。
この全体像を理解したうえで、それぞれの部分を詳しく見ていきます。
HTTP リクエストの構造
HTTP リクエストは、クライアントからサーバーに対して「この処理をしてほしい」と伝えるメッセージです。
例えば、ブラウザで Web ページを開く場合、ブラウザはサーバーに対してページのデータを取得したいことを HTTP リクエストとして伝えます。
HTTP リクエストは、基本的に「リクエストライン」「ヘッダー」「空行」「ボディ」という構造になっています。
リクエストライン
リクエストラインは、どのような処理をして、どのリソースを取得したいのかを示す部分です。
GET /index.html HTTP/1.1この 1 行には 3 つの情報があります。
GETは HTTP メソッドと呼ばれ、「データを取得したい」という意味です。/index.htmlはパスで、取得したいリソースの場所を示します。HTTP/1.1は使用する HTTP のバージョンを示しています。
つまり、この 1 行は「HTTP/1.1 を使って、/index.html を取得したい」という意味になります。
ヘッダー
ヘッダーは、リクエストに関する追加情報を伝える部分です。
Host: www.example.com
User-Agent: Mozilla/5.0
Host は、アクセス先のホスト名を示します。
User-Agent は、リクエストを送信しているクライアントに関する情報を示します。ブラウザからアクセスした場合は、使用しているブラウザなどの情報が含まれます。
このように、ヘッダーには「このリクエストについて、サーバーに伝えておきたい追加情報」が入ります。
空行
ヘッダーの後には空行があります。
この空行は、ヘッダーとボディを区切るためのものです。
HTTP メッセージでは、この区切りによって「ここまでがヘッダーで、ここからがボディ」ということが分かります。
ボディ
ボディは、リクエストと一緒に送信する実際のデータを入れる部分です。
例えば、フォームから名前や年齢などのデータを送信する場合、次のようなデータがボディに入ることがあります。
name=John&age=30ただし、すべての HTTP リクエストにボディが存在するわけではありません。例えば、単純に Web ページを取得する GET リクエストでは、ボディを使用しないことが一般的です。
HTTP レスポンスの構造
HTTP レスポンスは、サーバーがクライアントから受け取った HTTP リクエストに対して返すメッセージです。
例えば、ブラウザが /index.html を取得するリクエストを送ると、サーバーはその処理結果と HTML データを HTTP レスポンスとして返します。
HTTP レスポンスも、基本的に「ステータスライン」「ヘッダー」「空行」「ボディ」という構造になっています。
ステータスライン
ステータスラインは、サーバーがリクエストを処理した結果を示す部分です。
HTTP/1.1 200 OKHTTP/1.1は使用する HTTP のバージョンです。200はステータスコードで、リクエストが正常に処理されたことを示します。OKは、そのステータスコードを説明するテキストです。
つまり、この 1 行は「HTTP/1.1 を使用して、リクエストを正常に処理した」という意味になります。
ヘッダー
レスポンスのヘッダーには、サーバーから返すデータに関する追加情報が入ります。
Content-Type: text/html
Content-Length: 123
Content-Type は、ボディに入っているデータの種類を示します。text/html なら HTML データ、application/json なら JSON データであることを示します。Content-Length は、ボディに含まれるデータのサイズを示します。
空行
レスポンスでも、ヘッダーの後に空行があります。
この空行によって、ヘッダーとボディが区切られます。
ボディ
ボディには、サーバーがクライアントに返す実際のデータが入ります。
例えば、Web ページの HTML を返す場合は、次のようなデータが入ります。
<html>
  <body>Hello, World!</body>
</html>
ブラウザは、この HTML を受け取って内容を解析し、画面に Web ページとして表示します。
HTTP リクエストとレスポンスの関係
ここまでの内容をまとめると、ブラウザで Web ページを表示するときは、基本的に次のような流れになります。
ブラウザ
   ↓
HTTP リクエスト
「/index.html を取得したい」
   ↓
Web サーバー
   ↓
HTTP レスポンス
「正常に処理しました。HTML はこれです」
   ↓
ブラウザ
   ↓
Web ページを表示
つまり、HTTP メッセージは、クライアントとサーバーが HTTP を使って情報を伝えるためのメッセージです。
HTTP リクエストでは、クライアントがサーバーに対して「何をしてほしいのか」を伝えます。そして HTTP レスポンスでは、サーバーがその処理結果と必要なデータをクライアントに返します。
HTTP メッセージを理解するときは、まず「リクエストを送る → サーバーが処理する → レスポンスを返す」という全体の流れを理解し、その後でリクエストライン、ヘッダー、ボディなどの細かい構造を覚えると理解しやすくなります。
HTTPメソッド
HTTPメソッドは、Webブラウザ (クライアント) とWebサーバーが通信する際に、クライアントがサーバーに対してどのような操作を要求するかを指定するための手段です。
GETメソッド
- 用途: サーバーからデータを取得する際に使用します。
- 例: Webページの表示、画像や動画の取得など。
- 特徴: データの取得のみを行い、サーバーの状態を変更しません。
POSTメソッド
- 用途: サーバーにデータを送信し、新しいリソースを作成する際に使用します。
- 例: フォームの送信、新規投稿の作成など。
- 特徴: リクエストボディにデータを含めて送信し、サーバーで新しいリソースを作成します。
PUTメソッド
- 用途: サーバー上の既存のリソースを新しいデータで置き換える際に使用します。
- 例: ユーザー情報の更新、ファイルの上書きなど。
- 特徴: 指定されたURIのリソースを完全に置き換えます。
DELETEメソッド
- 用途: サーバー上の特定のリソースを削除する際に使用します。
- 例: 投稿の削除、アカウントの削除など。
- 特徴: 指定されたURIのリソースを削除します。
PATCHメソッド
- 用途: サーバー上のリソースの一部を更新する際に使用します。
- 例: ユーザー情報の一部変更、設定の更新など。
- 特徴: リソースの一部を更新するため、PUTメソッドよりも効率的です。
HEADメソッド
- 用途: サーバーからリソースのヘッダー情報のみを取得する際に使用します。
- 例: リソースのメタ情報 (サイズや最終更新日時など) を取得する際。
- 特徴: レスポンスボディは含まれず、ヘッダー情報のみが返されます。
OPTIONSメソッド
- 用途: サーバーがサポートしているHTTPメソッドを確認する際に使用します。
- 例: サーバーがどのメソッドをサポートしているかを調べる際。
- 特徴: サーバーがサポートするメソッドを確認するために使用されます。
「GET」と「POST」の違い
HTTPメソッドの「GET」と「POST」は、Webブラウザとサーバー間でデータをやり取りする際に使用される主要な方法です。これらのメソッドは、それぞれ異なる目的と特徴を持っています。
GETメソッド
- 目的: サーバーからデータを取得するために使用されます。
- データの送信方法: データはURLの一部として送信されます。具体的には、URLの末尾に「?」を付け、その後に「キー=値」の形式でパラメータを追加します。
→ 例:
http://example.com/search?query=猫&sort=asc - 特徴:
- データの可視性: URLにデータが含まれるため、ブラウザのアドレスバーで確認できます。
- データの長さ制限: URLの長さに制限があるため、大量のデータの送信には適していません。
- キャッシュ: GETリクエストはキャッシュされることが多く、同じリクエストを繰り返すとキャッシュからデータが取得される場合があります。
- セキュリティ: パスワードや個人情報などの機密データをGETリクエストで送信するのは避けるべきです。
POSTメソッド
- 目的: サーバーにデータを送信し、新しいリソースの作成や既存のリソースの更新を行うために使用されます。
- データの送信方法: データはHTTPリクエストのボディ部分に含まれ、URLには表示されません。
→ 例: フォームに入力したデータがリクエストボディに含まれます。
- 特徴:
- データの可視性: データはURLに含まれないため、アドレスバーで確認することはできません。
- データの長さ制限: 理論的には、POSTメソッドは大量のデータを送信できますが、サーバーやブラウザによって制限が設けられている場合があります。
- キャッシュ: POSTリクエストは通常キャッシュされません。
- セキュリティ: データがURLに表示されないため、GETメソッドよりもセキュアに見えますが、通信が暗号化されていない場合、データは依然として盗聴される可能性があります。
まとめ
- GETメソッド: データの取得に使用され、データはURLに含まれます。
- POSTメソッド: データの送信やリソースの作成・更新に使用され、データはリクエストボディに含まれます。
これらのメソッドは、Webアプリケーションの設計において適切に使い分けることが重要です。例えば、検索機能などのデータ取得にはGETメソッドを、ユーザー登録やログインなどのデータ送信にはPOSTメソッドを使用します。
ステータスコード
HTTPでは、サーバーがクライアントに返すレスポンスの結果を示すために、3桁のステータスコードが使用されます。ステータスコードはリクエストの成功、リダイレクト、クライアントエラー、サーバーエラーなど、様々な状態を表現します。
1xx (情報)
- 100 Continue
クライアントがリクエストを続行できることを示す。ヘッダーが受け入れられ、クライアントはボディを送信することが期待されます。
2xx (成功)
- 200 OK
リクエストが成功し、リクエストされた情報がレスポンスに含まれます。
3xx (リダイレクト)
- 301 Moved Permanently
リクエストされたリソースが新しい場所に永続的に移動します。ブラウザは次のリクエストから新しい場所を使用します。
- 302 Found (またはMoved Temporarily)
リクエストされたリソースが一時的に新しい場所に移動します。ブラウザは次のリクエストから新しい場所を使用します。
- 304 Not Found
リクエストされたコンテンツが未更新であることを通知します。Webブラウザに一次保存されたコンテンツが表示されます。
4xx (クライアントエラー)
- 400 Bad Request
クライアントのリクエストが不正であるため、サーバーがリクエストを理解できない場合表示されます。
- 401 Unauthorized
認証が必要なリソースに対して、クライアントが認証されていない場合表示されます。
- 403 Forbidden
クライアントがリソースにアクセスする権限がない場合表示されます。
- 404 Not Found
リクエストされたリソースが見つからない場合表示されます。
5xx (サーバーエラー)
- 500 Internal Server Error
サーバー内部でエラーが発生し、リクエストが処理できない場合表示されます。
- 502 Bad Gateway
ゲートウェイまたはプロキシサーバーが不正な応答を受け取り、サーバーがエラーを返した場合表示されます。
- 503 Service Unavailable
サーバーが一時的にダウンしているか、過負荷状態であるため、リクエストを処理できない場合表示されます。
これらは一般的なステータスコードの例であり、HTTPプロトコルには他にも多くのステータスコードが存在します。各ステータスコードは、通信の成功やエラーの詳細な状態をクライアントに伝えるために使われます。
メッセージヘッダー
HTTPメッセージヘッダーは、HTTPリクエストまたはレスポンス内の情報を伝達するためのメタデータの部分です。メッセージヘッダーを利用することでHTTPメッセージに関する詳細な情報を送信することが出来ます。
ヘッダーはキーと値のペアから構成され、通信の制御、認証、コンテンツの形式、クッキーなど、さまざまな目的で使用されます。
一般的ヘッダーフィールド
- Cache-Control: キャッシュの動作を指定します。
- Connection: リクエスト後はTCPコネクションを切断など接続状況に関する通知を示します。また、クライアントとサーバーの接続の管理方法を指定します。
- Date: HTTPメッセージが作成された日時を指定します。
- Upgrade: HTTPのバージョンをアップデートするように要求します。
- Cookie: クライアントからサーバーへのクッキーの送信やサーバーからのクッキーの受け取りに使用されます。
リクエストヘッダーフィールドの例
- Host: リクエスト先のサーバー名を指定します。
- Referer: 直前にリンクしていた (訪れていた) WebページのURLを指定します。
- User-Agent: ブラウザやクライアントの固有情報を提供します。(プロダクト名、バージョンなど)
- Accept: クライアントがサポートするメディアタイプを指定します。
レスポンスヘッダーフィールドの例
- Location: リダイレクト先のWebページ情報を指定します。
- Content-Type: レスポンスの本文のメディアタイプと文字エンコーディングを指定します。
- Content-Length: レスポンス本文の長さを指定します。
- Server: Webサーバーの種類やバージョンなどの情報を提供します。 (プロダクト名、バージョンなど)
エンティティヘッダーフィールド
- Allow: 利用可能なHTTPメソッドの一覧を指します。
- Content-Encoding: コンテンツのエンコード (データ変換) 方式を指します。
- Content-Language: コンテンツの使用言語を指します。
- Content-Length: コンテンツのサイズを指します。単位はバイト (byte)
- Content-Type: コンテンツの種類 (テキスト、画像) などを指します。
- Expires: コンテンツの有効期限を指します。
- Last-Modified: コンテンツの最終更新時刻
TCPによるデータ通信
Webサイトを閲覧するとき、ブラウザは Web サーバーに HTTP リクエストを送り、サーバーは HTTP レスポンスを返します。このやり取りを支えているのが TCP です。
HTTP は「どのようなデータを要求し、どのような形式で返すか」というルールを定めます。一方、TCP は、その HTTP のデータをクライアントとサーバーの間で正しく届ける役割を担当します。つまり、HTTP が「何をやり取りするか」を決め、TCP が「データを確実に届ける」役割を担っています。
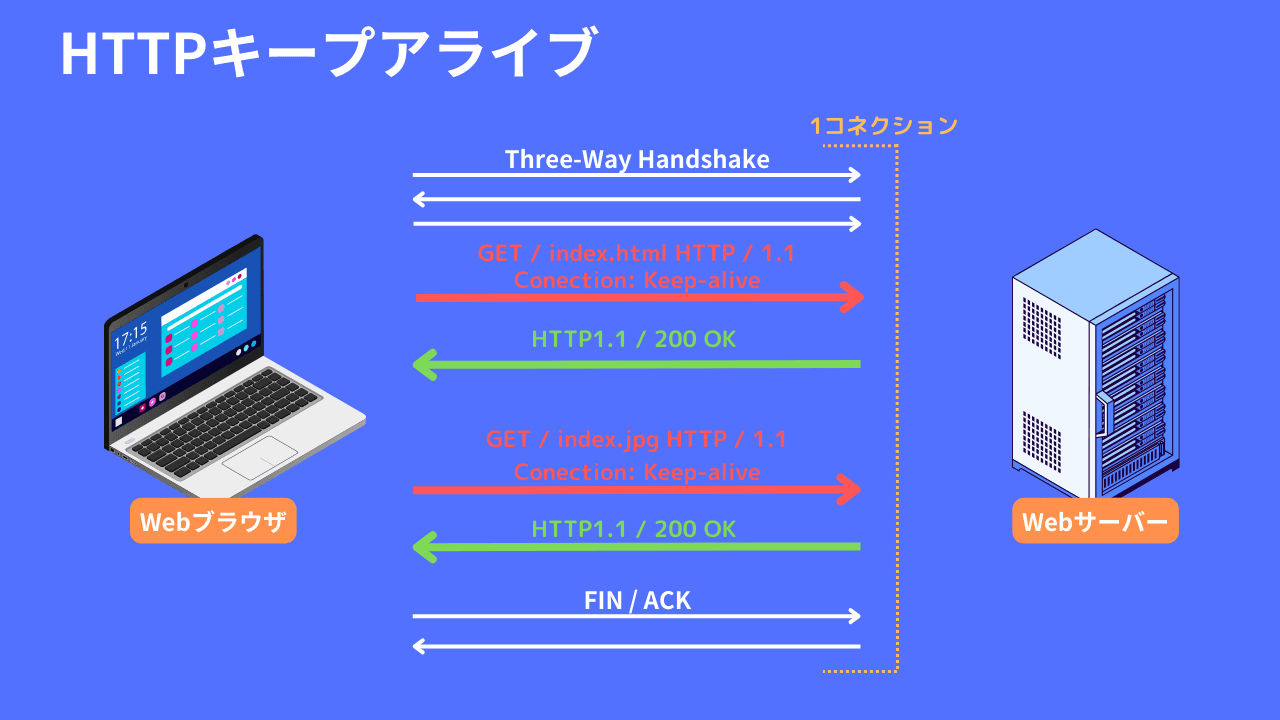
TCP では、データを送る前にクライアントとサーバーの間で「コネクション」と呼ばれる通信の準備を行います。この準備には、SYN → SYN-ACK → ACK の 3 回のやり取りを使います。これを「3 ウェイ・ハンドシェイク」と呼びます。
3 ウェイ・ハンドシェイク
- クライアント → サーバー:SYN
クライアントが「これから TCP 通信を開始したい」とサーバーに伝えます。このとき送信されるのが SYN です。
- サーバー → クライアント:SYN-ACK
サーバーは SYN を受け取ると、「通信を開始できます」と応答します。このとき、クライアントからの SYN を確認する ACK と、サーバー側からの SYN を同時に送ります。これが SYN-ACK です。
- クライアント → サーバー:ACK
クライアントはサーバーから SYN-ACK を受け取ると、「サーバーからの応答を確認しました」と ACK を返します。
この 3 回のやり取りが完了すると、TCP のコネクションが確立されます。その後、HTTP リクエストや HTTP レスポンスなどのデータを送受信します。
つまり、Web 通信の流れを簡単にすると、TCP で通信の準備をする → HTTP でリクエストを送る → サーバーが HTTP レスポンスを返すという流れになります。
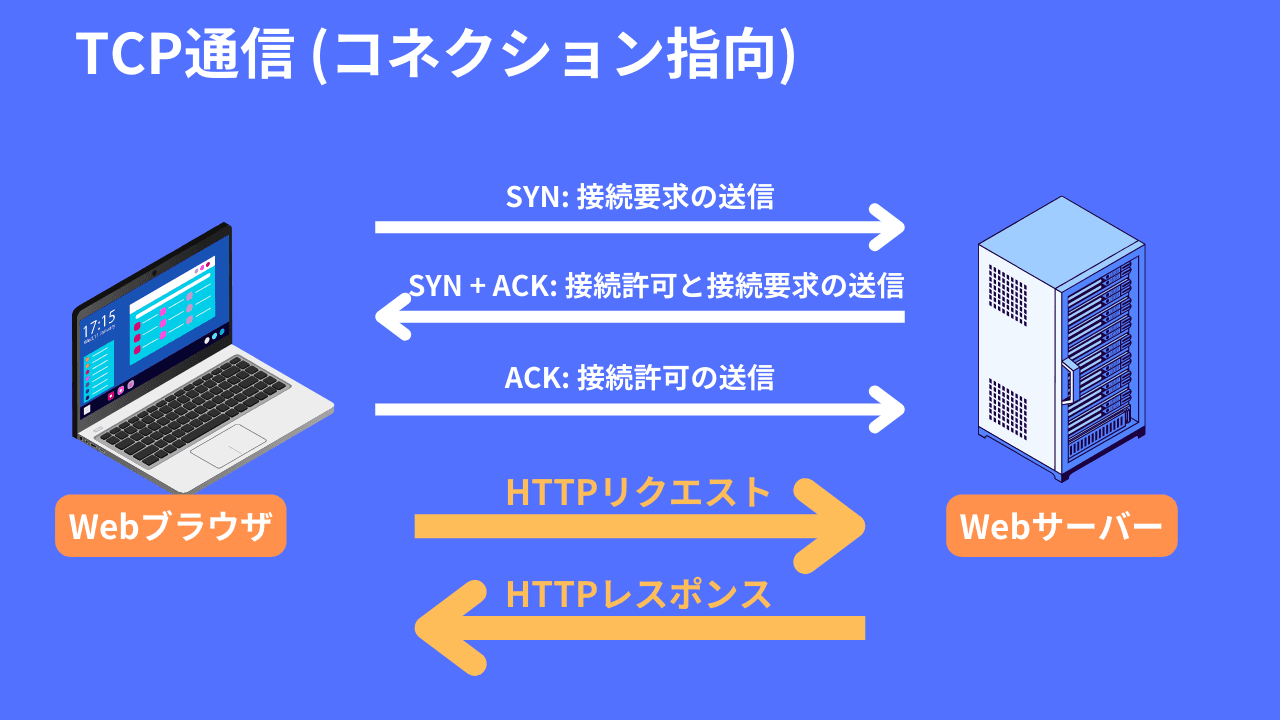
この手順は通常、「Three-Way Handshake」と呼ばれ、クライアントとサーバーの間で確実な通信の開始を保証します。この接続の確立後、クライアントとサーバーはデータの送受信を開始し、通信が終了するまでデータのやり取りが可能です。
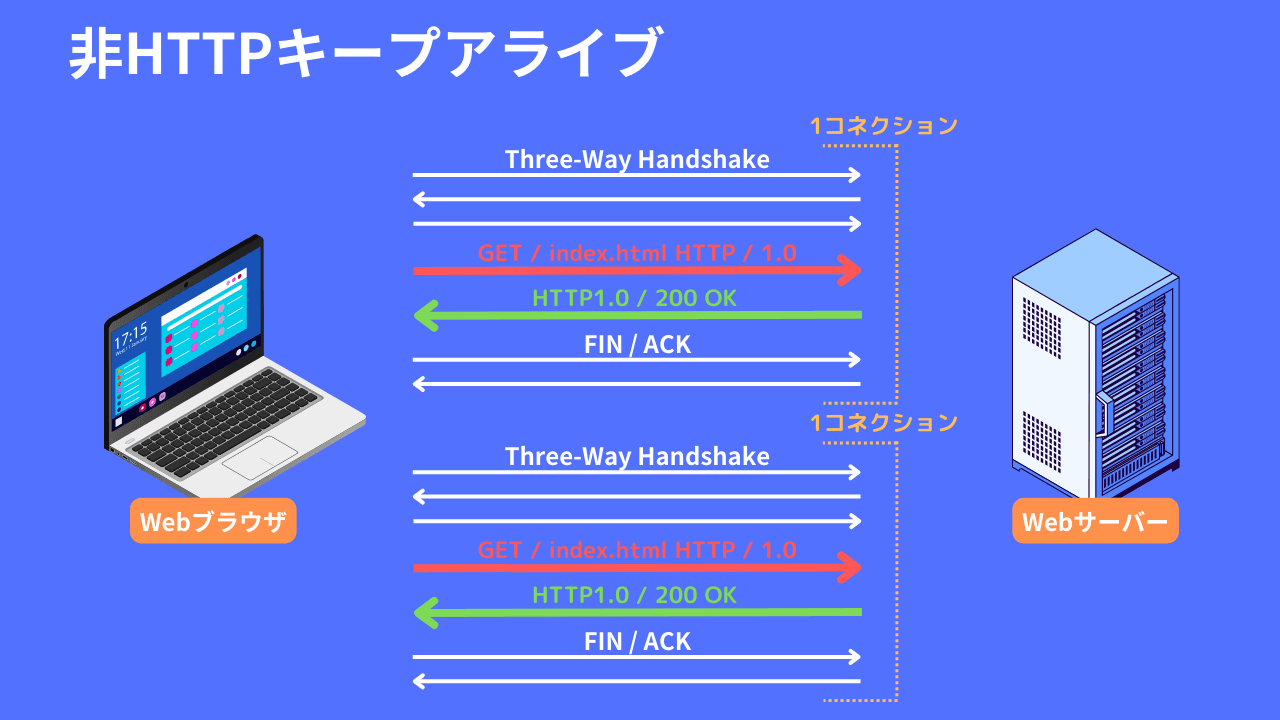
HTTP / 1.1 の HTTP キープアライブとは
HTTPキープアライブ (HTTP Keep-Alive) は、HTTPプロトコルにおいて、単一のTCP接続を使用して複数のHTTPリクエストおよびレスポンスをやり取りする仕組みを指します。通常、クライアントがサーバーにリクエストを送信し、サーバーがレスポンスを返すと、接続が閉じられます。しかし、HTTPキープアライブを使用すると、同一のTCP接続を再利用して複数のリクエストやレスポンスを行うことができます。
HTTP / 1.1 の HTTPパイプラインとは
HTTPパイプライン (HTTP Pipelining) は、HTTPプロトコルにおいて、複数のリクエストを一つのTCP接続で並行して送信し、サーバーからのレスポンスも同様に一つのTCP接続で非同期に受け取る仕組みです。通常、クライアントがサーバーに複数のリクエストを送信し、サーバーがその順序通りにレスポンスを返すまで待つ代わりに、HTTPパイプラインではリクエストが非同期に送信され、レスポンスも非同期に受信されます。
HTTPパイプラインの主な特徴と利点は以下の通りです。
- 並列処理
複数のリクエストを同時に送信できるため、通信の効率が向上します。これにより、通信の待ち時間が減少し、パフォーマンスが向上します。
- TCP接続の再利用
パイプラインが有効な接続では、同一のTCP接続を再利用して複数のリクエストおよびレスポンスを処理できるため、接続の確立や切断に伴うオーバーヘッドが減少します。
- リソースの効率的な利用
パイプラインを使用することで、サーバーとクライアントのリソースがより効率的に利用されます。
HTTP / 2 のストリームとは
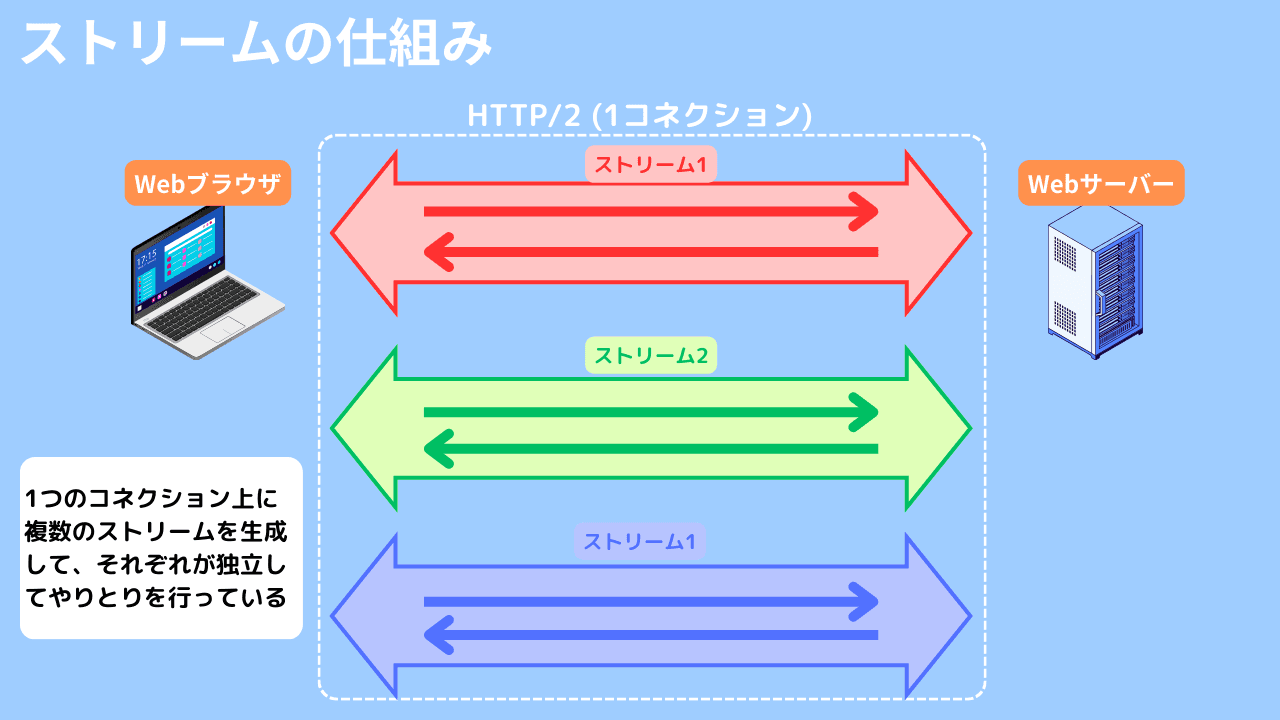
HTTP/2 では、1 つの TCP 接続の中で複数のリクエストとレスポンスを効率よく処理できる仕組みが導入されました。この仕組みを理解するうえで重要なのが「ストリーム」です。
ストリームとは、HTTP/2 において、1 つのリクエストと、それに対応するレスポンスを管理するための論理的な通信単位です。
例えば、ブラウザが Web ページを表示するときには、HTML だけでなく、画像、CSS、JavaScript など、複数のファイルをサーバーから取得する必要があります。
HTTP/1.1 では、こうした複数の通信を効率よく処理するために複数の TCP 接続を利用することがありました。一方、HTTP/2 では、1 つの TCP 接続の中に複数のストリームを作り、それぞれのストリームで別々のリクエストとレスポンスを処理できます。
イメージすると、次のようになります。
HTTP/1.1

TCP接続
 └─ リクエスト / レスポンス

TCP接続
 └─ リクエスト / レスポンス

TCP接続
 └─ リクエスト / レスポンス
HTTP/2 では、
1つのTCP接続
 ├─ ストリーム1 → HTML
 ├─ ストリーム2 → CSS
 ├─ ストリーム3 → JavaScript
 └─ ストリーム4 → 画像
というように、1 つの TCP 接続の中で複数の通信を扱えます。
さらに HTTP/2 では、それぞれのストリームのデータを細かい単位に分けて送信し、複数のストリームのデータを同じ TCP 接続上で交互に送ることができます。これを「多重化」と呼びます。
これにより、複数のリソースを効率よく取得できるようになり、Web ページの表示に必要な通信を効率化できます。
ただし、HTTP/2 でも TCP を使用するため、TCP のレベルでデータの再送が発生すると、その影響を受けることがあります。そのため、「HTTP/2 なら 1 つの通信が遅れても他の通信には一切影響しない」と考えるのは正確ではありません。
HTTP/2 では、このストリームによる多重化に加えて、ヘッダー圧縮などの仕組みも導入されています。これらによって、HTTP/1.1 と比べて Web 通信をより効率的に行えるようになりました。
まずは、HTTP/2 では 1 つの TCP 接続の中に複数のストリームを作り、複数のリクエストとレスポンスを効率よく処理できると理解しておけば十分です。
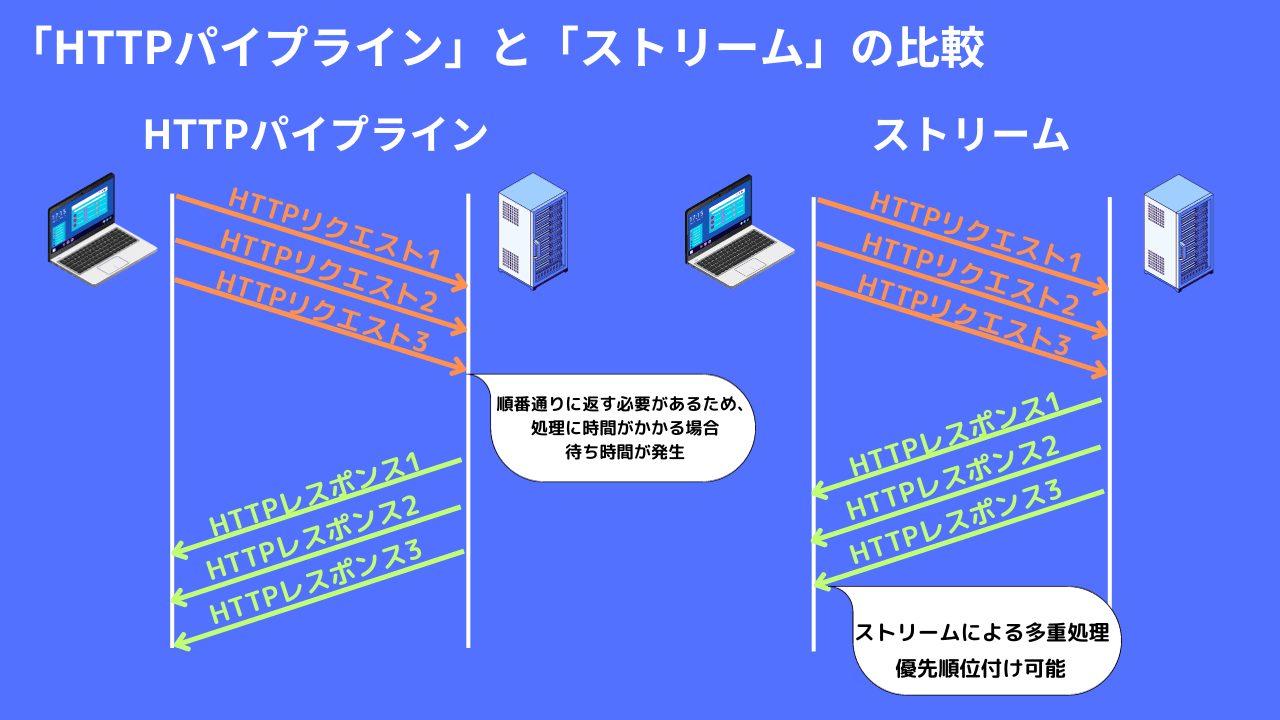
HTTPパイプラインとストリームは、どちらも複数リクエストを送信できることに変わりありません。しかし、HTTPパイプラインは順番通りにレスポンスする制約があるため、処理に時間がかかった際に待ち時間が発生します。
バイナリ形式の利用
HTTP/2 では、HTTP/1.1 のようなテキスト形式ではなく、バイナリ形式でデータをやり取りします。
バイナリ形式とは、データをコンピュータが扱いやすい 0 と 1 の組み合わせとして処理する形式です。人間が直接読んで理解するのは難しいですが、コンピュータにとっては処理しやすいという特徴があります。
一方、テキスト形式は、人間が読んで内容を理解しやすい形式です。例えば、HTTP/1.1 のリクエストでは、GET /index.html HTTP/1.1 のように文字として内容を確認できます。
HTTP/2 では、こうした HTTP の通信データをバイナリ形式で扱います。これにより、通信データを決められた形式で効率よく処理できるようになります。
ただし、バイナリ形式だから必ず通信量が大幅に小さくなる、という意味ではありません。 HTTP/2 では、バイナリ形式による効率的な処理に加えて、ヘッダー圧縮や多重化などの仕組みも組み合わせることで、Web 通信を効率化しています。
つまり、HTTP/2 のバイナリ形式は、人間が読みやすいことよりも、コンピュータが通信データを効率よく処理できることを重視した仕組みと考えると分かりやすいです。
ヘッダー圧縮
HTTP/2 では、HTTP ヘッダーを効率よく送信するための仕組みが導入されています。
HTTP の通信では、リクエストやレスポンスに毎回ヘッダーが含まれます。同じようなヘッダー情報を何度も送信すると、その分だけ通信するデータ量が増えてしまいます。
そこで HTTP/2 では、「HPACK」という仕組みを使ってヘッダーを圧縮します。HPACK では、すでに送信したヘッダー情報を記録しておき、同じ情報を何度も送る代わりに、その情報を参照することで通信するデータ量を減らします。
例えば、同じ Web サイトに対して複数のリクエストを送る場合、毎回同じヘッダー情報をすべて送信するのではなく、すでに送った情報を利用できます。
これにより、HTTP ヘッダーによる通信量を減らし、通信を効率化できます。
サーバープッシュ
サーバープッシュは、サーバーからクライアントへ、リクエストされていないリソースを先に送信できる HTTP/2 の機能です。
通常の HTTP 通信では、ブラウザが HTML を取得した後、その HTML に必要な CSS や JavaScript などを見つけて、追加のリクエストをサーバーへ送ります。
サーバープッシュでは、サーバーが「この HTML を取得したなら、この CSS も必要になるだろう」と判断し、ブラウザからのリクエストを待たずにリソースを送信できます。
これにより、必要なリソースを取得するまでの待ち時間を短縮できる可能性があります。
ただし、不要なリソースまで送信すると、かえって通信量が増えてしまいます。また、現在の主要なブラウザでは HTTP/2 のサーバープッシュ機能がサポートされていないため、現在の Web 開発で一般的に利用する機能ではありません。
そのため、HTTP/2 を学習する際は、サーバープッシュは「HTTP/2 で導入された機能の一つ」と理解しておけば十分です。